
AX transformation(AI 전환)
AI 파일럿의 95%가 프로덕션에 닿지 못하는 이유
금요일 오후, 어느 회사 회의실. 팀은 3개월 동안 붙잡고 있던 AI 챗봇 데모를 임원 앞에서 시연해요. 질문을 던지면 그럴듯한 답이 나오고, 다들 고개를 끄덕이죠. 그리고 그 프로젝트는… 딱 거기까지예요. 6개월 뒤엔 아무도 그 챗봇을 쓰지 않고요.
이게 예외적인 실패담이면 좋겠지만, 통계는 정반대를 말해요. MIT NANDA가 2025년에 내놓은 보고서 『The GenAI Divide』는 기업 생성형 AI 파일럿의 약 5%만이 매출로 이어지고, 나머지 대다수는 P&L에 아무런 측정 가능한 영향 없이 멈춘다고 정리했거든요.1 흔히 "95%가 실패한다"고 인용되는 그 숫자죠.
숫자 자체보다 중요한 건 왜예요. 그리고 여기서부터 대부분의 글이 엉뚱한 방향으로 새요.
모델이 더 좋아지면 정말 해결될까요?
가장 흔한 진단은 "아직 모델이 부족해서"예요. 편한 설명이긴 한데, 데이터는 이 진단을 지지하지 않거든요.
MIT 보고서가 콕 집은 표현은 하나예요 — 학습 격차, learning gap. ChatGPT 같은 범용 도구는 개인에게는 훌륭하지만, 기업 현장에서는 멈춰요. 보고서의 표현을 그대로 옮기면 "조직의 워크플로를 학습하거나 거기에 적응하지 못하기 때문"이죠.1 즉 모델이 멍청해서가 아니라, 똑똑한 모델이 우리 회사가 실제로 일하는 방식을 모른 채 겉도는 거예요.
보충. 이 지점이 늘 오해받아요. PoC(개념 증명)는 "모델이 이걸 할 수 있는가?"를 증명해요. 프로덕션은 "이게 매주 목요일 김 대리의 실제 업무 흐름 안에서, 예외 상황까지 포함해 돌아가는가?"를 증명하고요. 둘은 난도가 조금 다른 정도가 아니라, 아예 다른 종류의 문제예요. 필기시험 만점과 실제 도로 주행은 다른 얘기잖아요.
McKinsey의 2025년 조사가 이 그림을 완성해요. 이제 88%의 기업이 최소 한 개 부서에서 AI를 정기적으로 쓰지만, 전사 EBIT에 유의미한 영향을 봤다고 답한 곳은 약 6%에 불과해요.2 도입률과 성과 사이에 거대한 협곡이 있는 거죠.
그럼 그 6%는 뭐가 달랐을까요? McKinsey가 찾아낸, 수익성과 가장 강하게 상관된 단 하나의 변수는 이거였어요 — 워크플로 자체를 근본적으로 재설계했는가.2 도구를 얹기만 한 게 아니라, 일하는 방식을 다시 그린 팀만 숫자를 얻었죠.

살아남는 5%는 무엇을 다르게 할까요?
연구와 현장을 겹쳐 보면, 프로덕션까지 도달하는 팀에게서 반복되는 패턴이 보여요. 요약하면 세 가지예요.
| 구분 | 멈추는 95% | 살아남는 5% |
|---|---|---|
| 출발점 | "AI 챗봇 하나 만들자" (기술) | "이 반복 업무를 없애자" (업무) |
| 구축 방식 | 자체 구축 우선 (성공률 약 33%) | 검증된 것을 사서 붙임 (약 67%) |
| 사람의 자리 | 완전 자동화, 검토 제거 | 관문에 사람 남김 (안전장치) |
| 성패 판정 | 데모가 잘 되면 끝 | 실제 워크플로 안 지표로 확인 |
1. "모델 데모"가 아니라 "업무 한 개"에서 시작한다
실패하는 파일럿은 대개 "우리도 AI 챗봇 하나 만들자"로 시작해요. 성공하는 파일럿은 "매주 반복되는 이 업무 하나를 없애자"로 시작하고요. 목표가 기술이 아니라 업무인 거죠.
Anthropic이 엔지니어링 팀 이름으로 공개한 『Building Effective Agents』 가이드도 같은 말을 해요 — 한 가지를 잘하는 단순한 시스템에서 출발하고, 복잡성은 그것이 측정 가능한 가치를 줄 때만 더하라.3 화려한 멀티 에이전트부터 짓는 팀치고 프로덕션까지 가는 경우를 저는 별로 못 봤어요. 걷기도 전에 3단 옆돌기부터 하려는 셈이거든요.
필자 주. 조금 민망하지만 솔직하게 예를 들면 — 지금 읽고 계신 이 블로그가 그 원칙으로 돌아가요. 글 초안은 자동 파이프라인이 쓰고, 사람이 텔레그램으로 검토해 버튼 하나로 발행하거나 반려하죠. 처음부터 "완전 자동 발행"을 노렸다면 진작 사고가 났을 거예요. 사람의 승인 관문을 남긴 단순한 구조가 오히려 오래가거든요. (이 문단도 그 관문을 통과해 여기 있어요.)
2. 만들기 전에 "살까 vs 지을까"를 냉정하게 계산한다
엔지니어의 본능은 "직접 짓자"예요. 데이터는 그 본능을 경계하라고 말하고요. MIT 보고서에 따르면 전문 벤더와 협업해 도입한 경우 성공률이 약 67%였던 반면, 내부에서 자체 구축한 경우는 그 3분의 1 수준에 그쳤어요.1
핵심은 "직접 짓지 말라"가 아니에요. 우리의 진짜 경쟁력이 그 시스템을 짓는 데 있는가를 물으라는 거죠. 아니라면, 검증된 것을 사서 우리 워크플로에 붙이는 데 에너지를 쓰는 편이 승률이 높아요.
3. 사람을 흐름 안에 남긴다 (그리고 그걸 감시가 아니라 안전장치로 쓴다)
완전 자동화는 매력적이지만, 초기 프로덕션에서 인간 검토 단계를 없애는 건 대개 성급해요. 앞서 Anthropic 가이드가 강조한 것처럼, 신뢰는 샌드박스에서 충분히 테스트하고 가드레일을 두면서 점진적으로 확장하는 것이지, 처음부터 크게 거는 게 아니거든요.3
보충. "사람이 개입하면 자동화가 아니지 않냐"는 반론을 자주 들어요. 아니에요. 목표는 사람을 지우는 게 아니라, 사람이 판단할 가치가 있는 지점에만 사람을 남기는 거예요. 취합·분류·초안은 기계에게, 최종 판단과 예외 처리는 사람에게 맡기는 거죠. 이 경계선을 잘 긋는 팀이 결국 더 많이 자동화하더라고요.
첫 파일럿은 어떻게 골라야 할까요?
원리는 알겠는데 월요일 아침에 뭘 해야 하냐고요. 저희가 교육과 실무에서 쓰는 진단은 단순해요 — 저희는 이걸 파일럿 3조건 진단이라 불러요. 후보 업무를 놓고 세 가지를 물어봐요.
- 반복되는가 — 매주·매일 같은 형태로 돌아오는 일인가요. (한 번뿐인 일은 자동화 대상이 아니에요.)
- 규칙으로 설명되는가 — "이러면 저렇게"로 적을 수 있나요. 매번 판단이 달라지면 아직 사람의 몫이에요.
- 워크플로에 붙일 수 있는가 — 이게 결정적이에요. 결과물이 실제 업무 흐름(그 사람이 쓰는 도구, 다음 단계로 넘어가는 방식) 안으로 들어가는가, 아니면 별도 창에서 겉도는가.

앞의 둘은 대부분의 가이드가 말해요. 세 번째가 MIT가 말한 학습 격차의 실무 버전이고, 95%와 5%를 가르는 지점이죠. 좋은 답을 만드는 것과, 그 답이 일하는 방식 안에 들어가는 것은 다른 프로젝트예요.
사례 하나: 우리가 이 글을 발행하는 방식
추상적으로 들릴 테니, 저희가 실제로 돌리는 파이프라인 하나를 열어 볼게요. 바로 이 블로그예요.
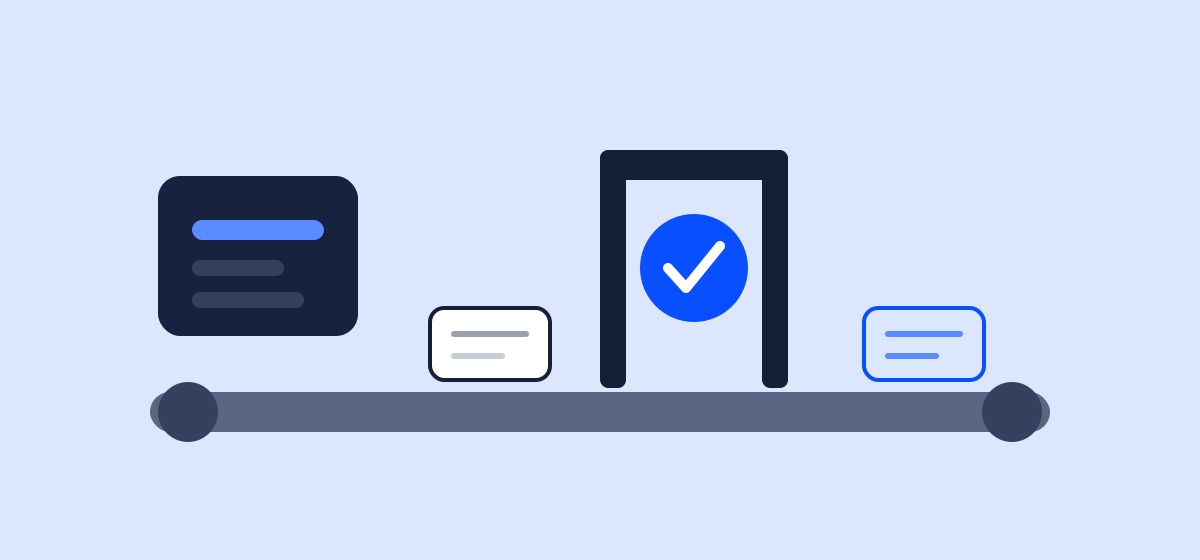
콘텐츠 발행은 3조건 진단을 그대로 통과해요. 정해진 요일마다 반복되고, "어떤 주제를 어떤 구조·톤으로 쓴다"는 규칙이 뚜렷하며, 초안에서 검토를 거쳐 발행에 이르는 워크플로가 이미 있죠. 그래서 자동화 1순위였어요.
| 3조건 진단 | 이 블로그의 경우 |
|---|---|
| 반복되는가 | 정해진 요일마다 반복 발행 |
| 규칙으로 설명되는가 | "어떤 주제를 어떤 구조·톤으로 쓴다"가 뚜렷 |
| 워크플로에 붙는가 | 초안 → 검토 → 발행 흐름이 이미 존재 |
설계는 앞의 세 원칙 그대로예요.
- 한 가지만 자동화했다. "블로그를 운영하는 AI"를 만들지 않았어요. 오직 "초안 생성" 한 스텝만 자동화하고, 나머지는 손대지 않았죠.
- 사서, 우리 흐름에 붙였다. 글쓰기 모델을 직접 만들지 않았어요. 이미 잘하는 Claude를 그대로 쓰고, 우리 발행 워크플로에 연결하는 "얇은 접착제"만 직접 짰죠. MIT가 말한 "살까 vs 지을까"의 실전 답이에요.
- 사람을 관문에 남겼다. 정해진 시각에 초안이 생기면, 실제 사이트와 똑같이 렌더된 미리보기 링크가 휴대폰으로 와요. 저는 그걸 열어 보고 [발행]·[재작성]·[보류] 중 하나를 누르기만 하죠. 판단은 사람이, 반복 노동은 기계가.
거창한 시스템이 아니에요. 오히려 그 반대라서 살아남았죠. 솔직히 말하면, 지금 이 글도 그 자동 초안 위에 사람 손을 꽤 얹었어요 🙂 — 자동화가 초안을 여기까지 끌어올리면, 사람은 남은 판단과 검증에 집중하면 되거든요. 그 분업이 핵심이에요.
정리
AI 도입의 병목은 대체로 모델이 아니에요. 조직의 워크플로죠. 그래서 이건 기술 프로젝트인 동시에 — 어쩌면 더 크게 — 업무 재설계 프로젝트예요. 파일럿을 데모로 끝내지 않으려면, 처음부터 "이 답이 누구의 어떤 흐름 안으로 들어가는가"를 설계에 넣어야 해요.
거창한 전사 전략이 필요한 게 아니에요. 반복·규칙·워크플로 세 조건을 만족하는 업무 하나를 골라, 단순하게 시작하고, 사람을 관문에 남기고, 숫자가 나오면 옆으로 복제하는 것 — 살아남은 5%가 실제로 한 일은 대개 이 정도로 담백했거든요.
자주 묻는 질문 (FAQ)
Q. AI 파일럿의 95%가 실패한다는 게 사실인가요? A. MIT NANDA의 2025년 보고서 기준, 기업 생성형 AI 파일럿의 약 5%만 매출로 이어지고 나머지는 P&L에 측정 가능한 영향 없이 멈춰요. 모델 성능이 아니라 조직의 워크플로에 붙지 못하는 '학습 격차'가 원인이에요.
Q. 더 좋은 모델이 나오면 해결되나요? A. 데이터는 아니라고 말해요. McKinsey의 2025년 조사에서 수익성과 가장 강하게 상관된 변수는 모델 성능이 아니라 '워크플로 자체를 재설계했는가'였거든요.
Q. 직접 만드는 것과 사서 붙이는 것 중 무엇이 유리한가요? A. MIT 기준 외부 전문 파트너와 협업한 경우 성공률이 약 67%로, 내부 자체 구축(약 33%)의 두 배를 넘었어요. 그 시스템을 짓는 것이 우리 핵심 경쟁력이 아니라면, 검증된 것을 사서 워크플로에 붙이는 편이 승률이 높아요.
Q. 첫 파일럿은 어떤 업무로 시작해야 하나요? A. 반복성·규칙성·워크플로 적합이라는 3조건을 모두 만족하는 업무 하나를 고르세요. 특히 결과물이 실제 업무 흐름 안으로 들어가는지가 95%와 5%를 가른답니다.
이 글을 여기까지 읽었다면, 아마 팀이나 조직에 AI를 어떻게 들일지 저울질하는 중일 거예요. 클래스도산이 다루는 건 정확히 그 지점 — 모델 자랑이 아니라 "일하는 방식을 바꾸는" 쪽이에요.
- 빠르게 감을 잡고 싶다면, 코딩 없이 반복 업무 하나를 직접 자동화해 보는 원데이 클래스가 가장 짧은 출발점이에요.
- 팀 단위 도입을 고민 중이라면, 이런 분석과 실전 사례를 정기적으로 정리해 보내드려요. 아래에서 구독하면 다음 글을 놓치지 않아요.
출처
- MIT NANDA, 『The GenAI Divide: State of AI in Business 2025』 (lead author Aditya Challapally). 150건 리더 인터뷰·350명 설문·300건 공개 배포 분석 기반. 요약: Fortune, 2025-08-18
- McKinsey QuantumBlack, The state of AI in 2025: Agents, innovation, and transformation (2025)
- Anthropic, Building Effective Agents (엔지니어링 블로그, 2024)
Footnotes
-
MIT NANDA(2025). 인용 수치와 "learning gap" 표현은 Fortune(2025-08-18)에 요약된 보고서 내용을 따랐습니다. ↩ ↩2 ↩3
-
McKinsey(2025), 『The state of AI in 2025』. 88% 도입률, 약 6%의 유의미한 EBIT 영향, 워크플로 재설계와의 상관 관련. ↩ ↩2
-
Anthropic(2024), 『Building Effective Agents』. "start simple, add complexity only when it delivers measurable value." ↩ ↩2