
AI·자동화 트렌드
AI 에이전트 옵저버빌리티: 상태 코드는 초록불인데 왜 돈이 새나요?
AI 에이전트 옵저버빌리티: 프로덕션에서 실패 지점과 비용을 추적하는 3층 관측 모델
월요일 아침에 대시보드를 열었는데 주말 토큰 사용량이 평일의 몇 배로 튀어 있어요. 에러 로그를 뒤져도 500은 0건. 전부 "성공"했거든요. 에이전트가 같은 검색 툴을 47번 부르고 매번 200 OK를 받았을 뿐입니다.
AI 에이전트 옵저버빌리티는 에이전트 실행의 모든 단계를 추적해 어디서 틀렸고 얼마를 썼는지 사후에 재구성하는 체계예요.
한눈 요약:
- 에이전트는 에러 없이 실패합니다. 상태 코드로는 안 잡혀요.
- 최소 단위는 로그가 아니라 스팬입니다. 툴 이름·인자·재시도·종료 사유 네 개는 꼭 남기세요.
- 대시보드는 실행층·판단층·비용층 셋이면 충분합니다(AX Lab 3층 관측 모델).
- 비용 폭주의 주범은 재시도가 아니라 컨텍스트 누적이에요.
AI 에이전트 옵저버빌리티는 기존 APM과 뭐가 다른가요?
출력이 비결정적이고, 요청 하나가 수십 스텝으로 쪼개지고, 상태 코드가 성공 여부를 못 알려준다 — 이 셋입니다.
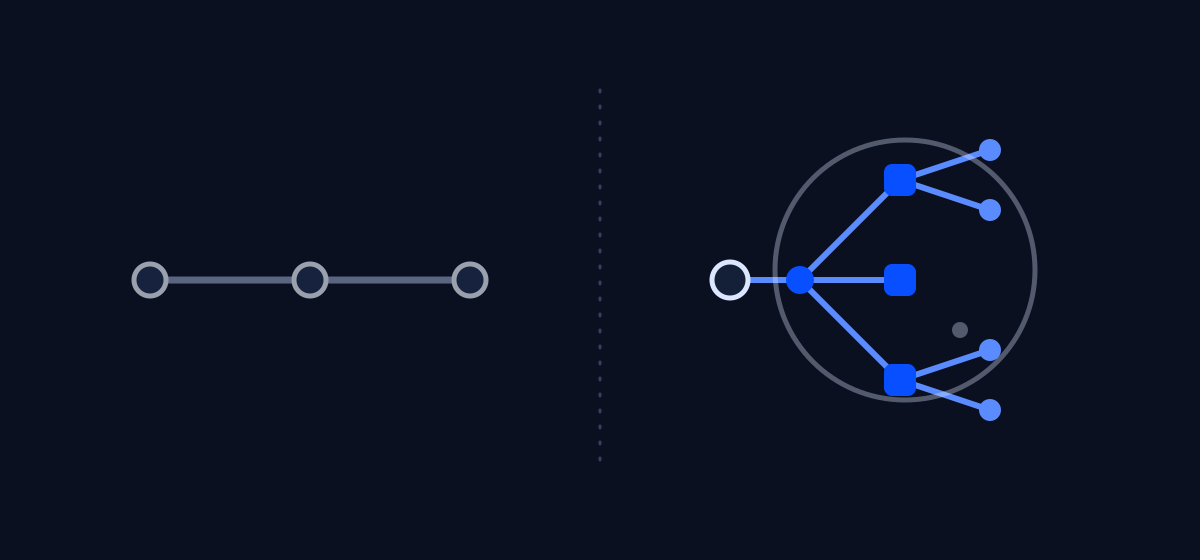
구글 SRE 팀이 정리한 모니터링의 네 가지 황금 신호는 지연·트래픽·에러·포화(자원이 얼마나 꽉 찼는지)예요1. 전통적인 웹 서비스는 이 넷이면 됐습니다. 에이전트는 에러율 0%, p95 지연(느린 쪽 5%를 잘라낸 응답 시간) 정상인데 답이 통째로 틀린 상태가 가능해요. 신호등이 전부 초록불인 채로 서비스가 망가지는 셈이죠.
Anthropic은 『Building Effective Agents』에서 "계획 단계를 명시적으로 드러낼 것", "에이전트-컴퓨터 인터페이스(ACI)를 문서 쓰듯 공들여 설계할 것"을 원칙으로 꼽았어요2. 관측 가능성이 운영 도구가 아니라 설계 요건이라는 뜻입니다. 나중에 로그를 붙이는 게 아니라, 처음부터 단계가 밖으로 보이게 만드세요.
프로덕션 에이전트는 주로 어디서 실패하나요?
툴 호출, 루프, 컨텍스트, 인젝션, 환각 — 다섯 갈래고, 다섯 개 모두 HTTP 200으로 위장합니다.
작업이 길어질수록 나빠져요. METR의 장기 작업 측정 연구는 2019~2025년 추세에서 50% 성공률 기준 "시간 지평"이 약 7개월마다 2배로 늘었지만, 80% 성공률을 요구하면 그 지평이 훨씬 짧아진다고 보고했습니다3. 스텝이 늘면 실패 확률이 곱해진다는 직관과 맞아요.
| 실패 유형 | 겉보기 증상 | 이걸 남겨야 잡힙니다 |
|---|---|---|
| 툴 호출 실패 | "죄송합니다"만 반복 | 툴 이름·인자·반환값 크기·에러 원문 |
| 순환 루프 | 응답은 오는데 토큰만 급증 | 스텝 수, 직전 호출과 인자 동일성 |
| 컨텍스트 초과·손실 | 초반 지시를 중간에 잊음 | 스텝별 입력 토큰, 잘림 여부 |
| 프롬프트 인젝션 | 의도 밖 툴이 호출됨 | 외부 문서 유입 지점, 호출 전 계획 텍스트 |
| 환각 기반 액션 | 없는 ID로 쓰기 작업 | 액션 인자와 원본 데이터 대조 기록 |
OWASP는 2025년 LLM 애플리케이션 위험 목록에서 프롬프트 인젝션을 LLM01로, 무제한 소비(Unbounded Consumption)를 LLM10으로 올렸어요4. 뒤쪽은 말 그대로 지갑 고갈 공격입니다.
트레이싱한다는 게 구체적으로 뭔가요?
트레이스는 요청 한 건의 전체 여정, 스팬은 그 안의 단일 단계예요. 플래닝 한 번, LLM 호출 한 번, 툴 실행 한 번이 각각 스팬이 되고 부모-자식으로 묶여 나무 모양이 됩니다.
OpenTelemetry가 이걸 표준화하는 중이에요. GenAI 시맨틱 컨벤션은 gen_ai.operation.name 아래 chat·execute_tool·invoke_agent를 정의하고, gen_ai.usage.input_tokens와 gen_ai.usage.output_tokens에 토큰 사용량을 싣습니다5. 집필 시점 문서 기준 이 규약은 development 상태라 속성 이름이 바뀔 여지가 있어요. 그래도 자체 포맷을 새로 만드는 것보다 낫습니다.
스팬에 꼭 넣을 필드는 네 개로 좁혀집니다. 선택한 툴 이름과 인자, 반환 결과의 크기, 재시도 횟수, 종료 사유(stop reason). 여기에 session_id와 user_id를 모든 스팬에 상속시키세요. 이게 없으면 뒤에 나올 비용 귀속이 통째로 불가능해집니다.
보충. 프롬프트 원문을 통째로 저장할지 미리 정하세요. 개인정보가 섞인 입력을 무심코 트레이스에 남겼다가 로그 보관 정책과 충돌하는 일이 생깁니다. 기본은 해시와 길이만, 전문은 샘플링해서 일부만.
대시보드에 뭘 올려야 하나요 — AX Lab 3층 관측 모델
세 개 층, 층마다 지표 2~3개면 충분합니다. 백 개 만들면 아무도 안 봐요.
| 층 | 답하는 질문 | 대시보드 지표 | 경보 임계값 |
|---|---|---|---|
| 실행층 | 돌아가긴 했나요? | 툴 호출 성공률, p95 실행 시간, 스텝 수 분포 | 스텝 수 p99가 설정 상한의 80% 초과 |
| 판단층 | 옳은 선택이었나요? | 목표 달성률, 사람 개입률, 재계획 횟수 | 사람 개입률 전주 대비 2배 |
| 비용층 | 얼마 썼나요? | 세션당 토큰·비용, 재시도 토큰 비중, 캐시 적중률 | 재시도가 전체 입력 토큰의 20% 초과 |
실행층만 보는 팀이 가장 흔해요. 그런데 앞에서 본 조용한 실패는 전부 판단층과 비용층에서 터집니다. 실행층은 이미 초록불이니까요.
비용은 어디서 새나요?
재시도, 컨텍스트 누적, 상한 부재 — 이 셋이고 진짜 무서운 건 두 번째입니다.
멀티스텝 에이전트는 매 스텝마다 지금까지의 대화 이력 전체를 다시 입력으로 보내요. 스텝이 n개면 총 입력 토큰은 n에 비례하는 게 아니라 n²에 가깝게 늘어납니다. 어려운 이론이 아니라 1+2+…+n을 더한 결과예요. 스텝을 10에서 20으로 늘리면 비용은 2배가 아니라 4배 근처가 됩니다. 실패한 호출도 입력 토큰은 이미 과금된 뒤고요.
그래서 비용은 세 층위로 붙이세요. 요청 단위(어느 스텝이 비쌌나), 세션 단위(이 작업 하나에 얼마), 사용자·테넌트 단위(누가 태우고 있나). 세 번째가 있어야 고객 한 명이 전체 비용의 절반을 쓰는 상황을 발견합니다.
방어선은 단순해요. 스텝 상한, 세션당 토큰 예산, 동일 인자 반복 호출 차단. 캐시 적중률도 지표로 올려두세요. Anthropic API는 응답 usage에 cache_read_input_tokens와 cache_creation_input_tokens를 따로 돌려주니 반복 프리픽스가 캐시를 타는지 숫자로 확인됩니다6. 🙂
상용 도구를 살까요, 직접 만들까요?
계측은 표준으로 직접, 저장과 시각화는 사는 조합이 기본값입니다.
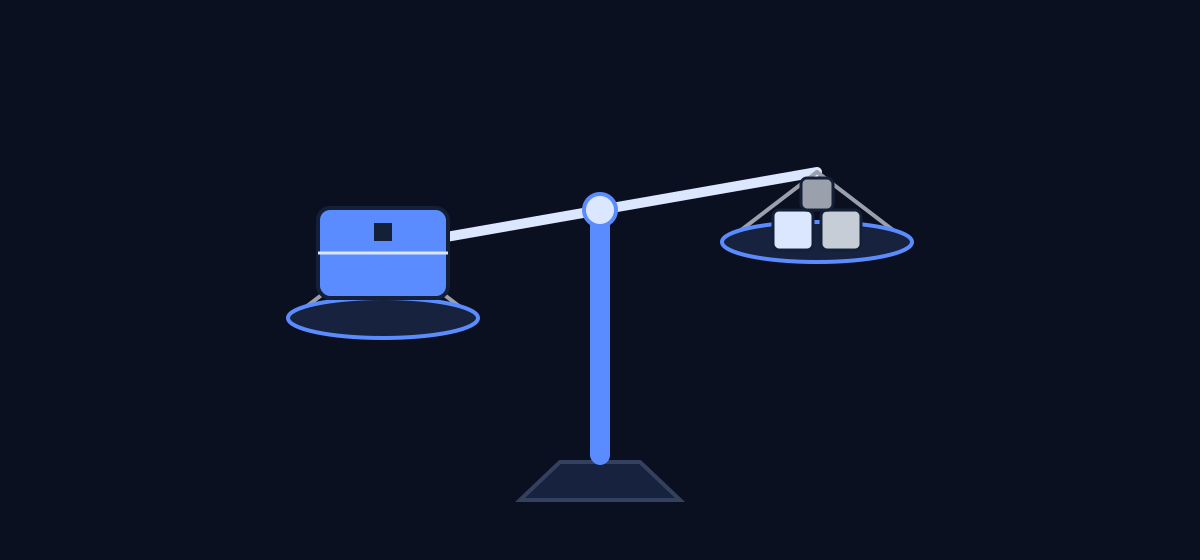
| 판단 기준 | 상용 도구 | 자체 구축 |
|---|---|---|
| 프롬프트 반출 | 외부 전송이 정책상 허용 | 원문 외부 반출 금지 |
| 기존 스택 | 이미 APM 상용 도구 운영 중 | 사내 로그 파이프라인이 표준화됨 |
| 평가 루프 | 데이터셋·회귀 평가까지 필요 | 평가 기준이 도메인 특수 |
| 인력 | 전담 플랫폼 인력 0명 | 유지보수 인력 상시 확보 |
LangSmith는 트레이스와 실행 트리를 중심으로 평가까지 묶은 도구고7, Datadog LLM Observability는 기존 APM 트레이스와 같은 화면에서 LLM 스팬과 토큰 비용을 보는 쪽에 강합니다8. 뭘 고르든 계측 코드를 OTel GenAI 규약에 맞춰두면 갈아탈 때 SDK만 바꾸면 돼요. 벤더 종속은 대시보드가 아니라 계측 레이어에서 생깁니다.
그래서 뭐부터 하면 되나요?
종료 조건부터 쓰세요. 그다음이 스팬입니다.
솔직하게 짚자면, AX Lab은 "옵저버빌리티 도입으로 장애 복구 시간이 몇 % 줄었다" 같은 자체 검증 수치를 갖고 있지 않아요. 그래서 원칙으로만 말씀드립니다. 디버깅 시간은 재현 시간과 원인 특정 시간의 합인데, 비결정적 시스템에서 재현은 가장 비싼 항이에요. 실패한 실행의 전체 트레이스가 남아 있으면 이 항이 0에 수렴하고 읽는 시간만 남습니다. 비용도 같은 구조예요. 측정하지 않는 값은 줄일 수 없거든요.
교육 현장에서 비개발자분들이 만든 에이전트를 볼 때 가장 먼저 눈에 띄는 건 로그가 아니라 종료 조건이에요. 언제 멈출지 정의 안 된 에이전트는 아무리 잘 관측해도 관측 결과가 "계속 돌고 있음"뿐입니다.
오늘 할 일은 셋입니다. 종료 조건과 스텝 상한 명문화, 스팬에 툴 이름·인자·재시도·종료 사유 네 필드 추가, 세션당 스텝 수와 토큰 비용 두 지표로 대시보드 시작.
직접 만들며 익히고 싶다면 AX Lab 클로드 바이브 코딩 원데이 클래스에서 5시간 동안 결과물 하나를 완성해보세요 → axlab.dosanprivate.com
자주 묻는 질문
Q. 로그만 잘 남겨도 되지 않나요? A. 안 됩니다. 로그는 시점별 기록이라 "3번째 스텝의 툴 호출이 5번째 재계획을 유발했다"는 인과를 못 보여줘요. 부모-자식 관계를 가진 스팬 구조가 필요합니다.
Q. 트레이스를 전부 저장하면 비용이 크지 않나요? A. 그래서 샘플링을 씁니다. 실패·에러·고비용 실행은 100% 저장하고 정상 실행은 일부만 남기세요. 메트릭은 전량 집계하고 트레이스만 샘플링하면 됩니다.
Q. 어떤 지표부터 만들어야 하나요? A. 세션당 스텝 수 분포와 세션당 토큰 비용, 둘부터요. AX Lab 3층 관측 모델에서 실행층과 비용층의 최소 조합이고, 루프와 비용 폭주라는 가장 흔한 두 사고를 동시에 커버합니다.
Q. OTel GenAI 규약이 아직 개발 단계인데 지금 써도 되나요? A. 써도 됩니다. 속성 이름은 바뀔 수 있지만 계측 지점을 어디 둘지에 대한 설계는 규약이 안정화돼도 그대로 유효해요. 속성 매핑을 어댑터 한 군데로 모아두면 변경에 대응됩니다.
출처
Footnotes
-
Google SRE, 『Site Reliability Engineering』 "Monitoring Distributed Systems" — 지연·트래픽·에러·포화의 네 가지 황금 신호. https://sre.google/sre-book/monitoring-distributed-systems/ ↩
-
Anthropic, 『Building Effective Agents』(2024) — 계획 단계의 명시적 노출과 에이전트-컴퓨터 인터페이스(ACI) 설계 권고. https://www.anthropic.com/engineering/building-effective-agents ↩
-
METR, 『Measuring AI Ability to Complete Long Tasks』(2025) — 50% 성공률 기준 시간 지평의 약 7개월 배증 추세, 80% 기준 지평의 단축. https://metr.org/blog/2025-03-19-measuring-ai-ability-to-complete-long-tasks/ ↩
-
OWASP GenAI Security Project, 『OWASP Top 10 for LLM Applications 2025』 — LLM01 Prompt Injection, LLM10 Unbounded Consumption. https://genai.owasp.org/llm-top-10/ ↩
-
OpenTelemetry, 『Semantic Conventions for Generative AI』 — gen_ai 네임스페이스의 스팬·속성 정의. https://opentelemetry.io/docs/specs/semconv/gen-ai/ ↩
-
Anthropic, 『Prompt caching』 Documentation — usage 응답의 cache_creation_input_tokens · cache_read_input_tokens 필드. https://docs.anthropic.com/en/docs/build-with-claude/prompt-caching ↩
-
LangSmith Documentation — 트레이스·실행 트리 기반 관측 및 평가. https://docs.smith.langchain.com/ ↩
-
Datadog, 『LLM Observability』 Documentation — LLM 스팬 추적과 토큰·비용 모니터링. https://docs.datadoghq.com/llm_observability/ ↩